看媒体写的东西,要学会区分事实和观点。
事实是有价值的,观点大部分时候没有价值,除非你需要编故事或者做 PPT。
大部分的媒体从业者没有做生意的经验,他们形成的观点要么是基于采访,也就是从业者的转述,要么是自己基于事实总结抽象。
出于「制造爆款」的动机,他们在总结、提炼的时候总喜欢放大一些「独特」、「新颖」、或者「耸人听闻」的细节,或者把某些企业的成功归因于决策者的一些「从来没人做过,但又十分合理的」判断。
跌宕起伏、一波三折的故事固然更吸引人,但是「故事会」注定只能是消遣,上不得台面。
看媒体写的东西,要学会区分事实和观点。
事实是有价值的,观点大部分时候没有价值,除非你需要编故事或者做 PPT。
大部分的媒体从业者没有做生意的经验,他们形成的观点要么是基于采访,也就是从业者的转述,要么是自己基于事实总结抽象。
出于「制造爆款」的动机,他们在总结、提炼的时候总喜欢放大一些「独特」、「新颖」、或者「耸人听闻」的细节,或者把某些企业的成功归因于决策者的一些「从来没人做过,但又十分合理的」判断。
跌宕起伏、一波三折的故事固然更吸引人,但是「故事会」注定只能是消遣,上不得台面。
在 vim 这种模态编辑器里输入中文体验太差了:
在计算机世界里,能直接用键盘打出来的拉丁字母语言是一等公民,非拉丁语语言是二等公民,阿拉伯语、希伯来语这种 RTL 语言就是三等公民。
我应该庆幸现代中文没有保留竖排习惯。要是中文保持竖排,中国的互联网产业得倒退 20 年。
Python 都能有 ty 这样的 lsp 了,uv 已经 make python great again and again 了,Evan You 能不能搞快点!
啊哈!抓住你了!一个伪装成原生应用的网页!

过去十年,新媒体式写作造成「语言通货膨胀」,所谓的 AI slop 就是这种文本特征极化的结果,真是没眼看🤦。
第三个网站 Read PDF Aloud 上线了。
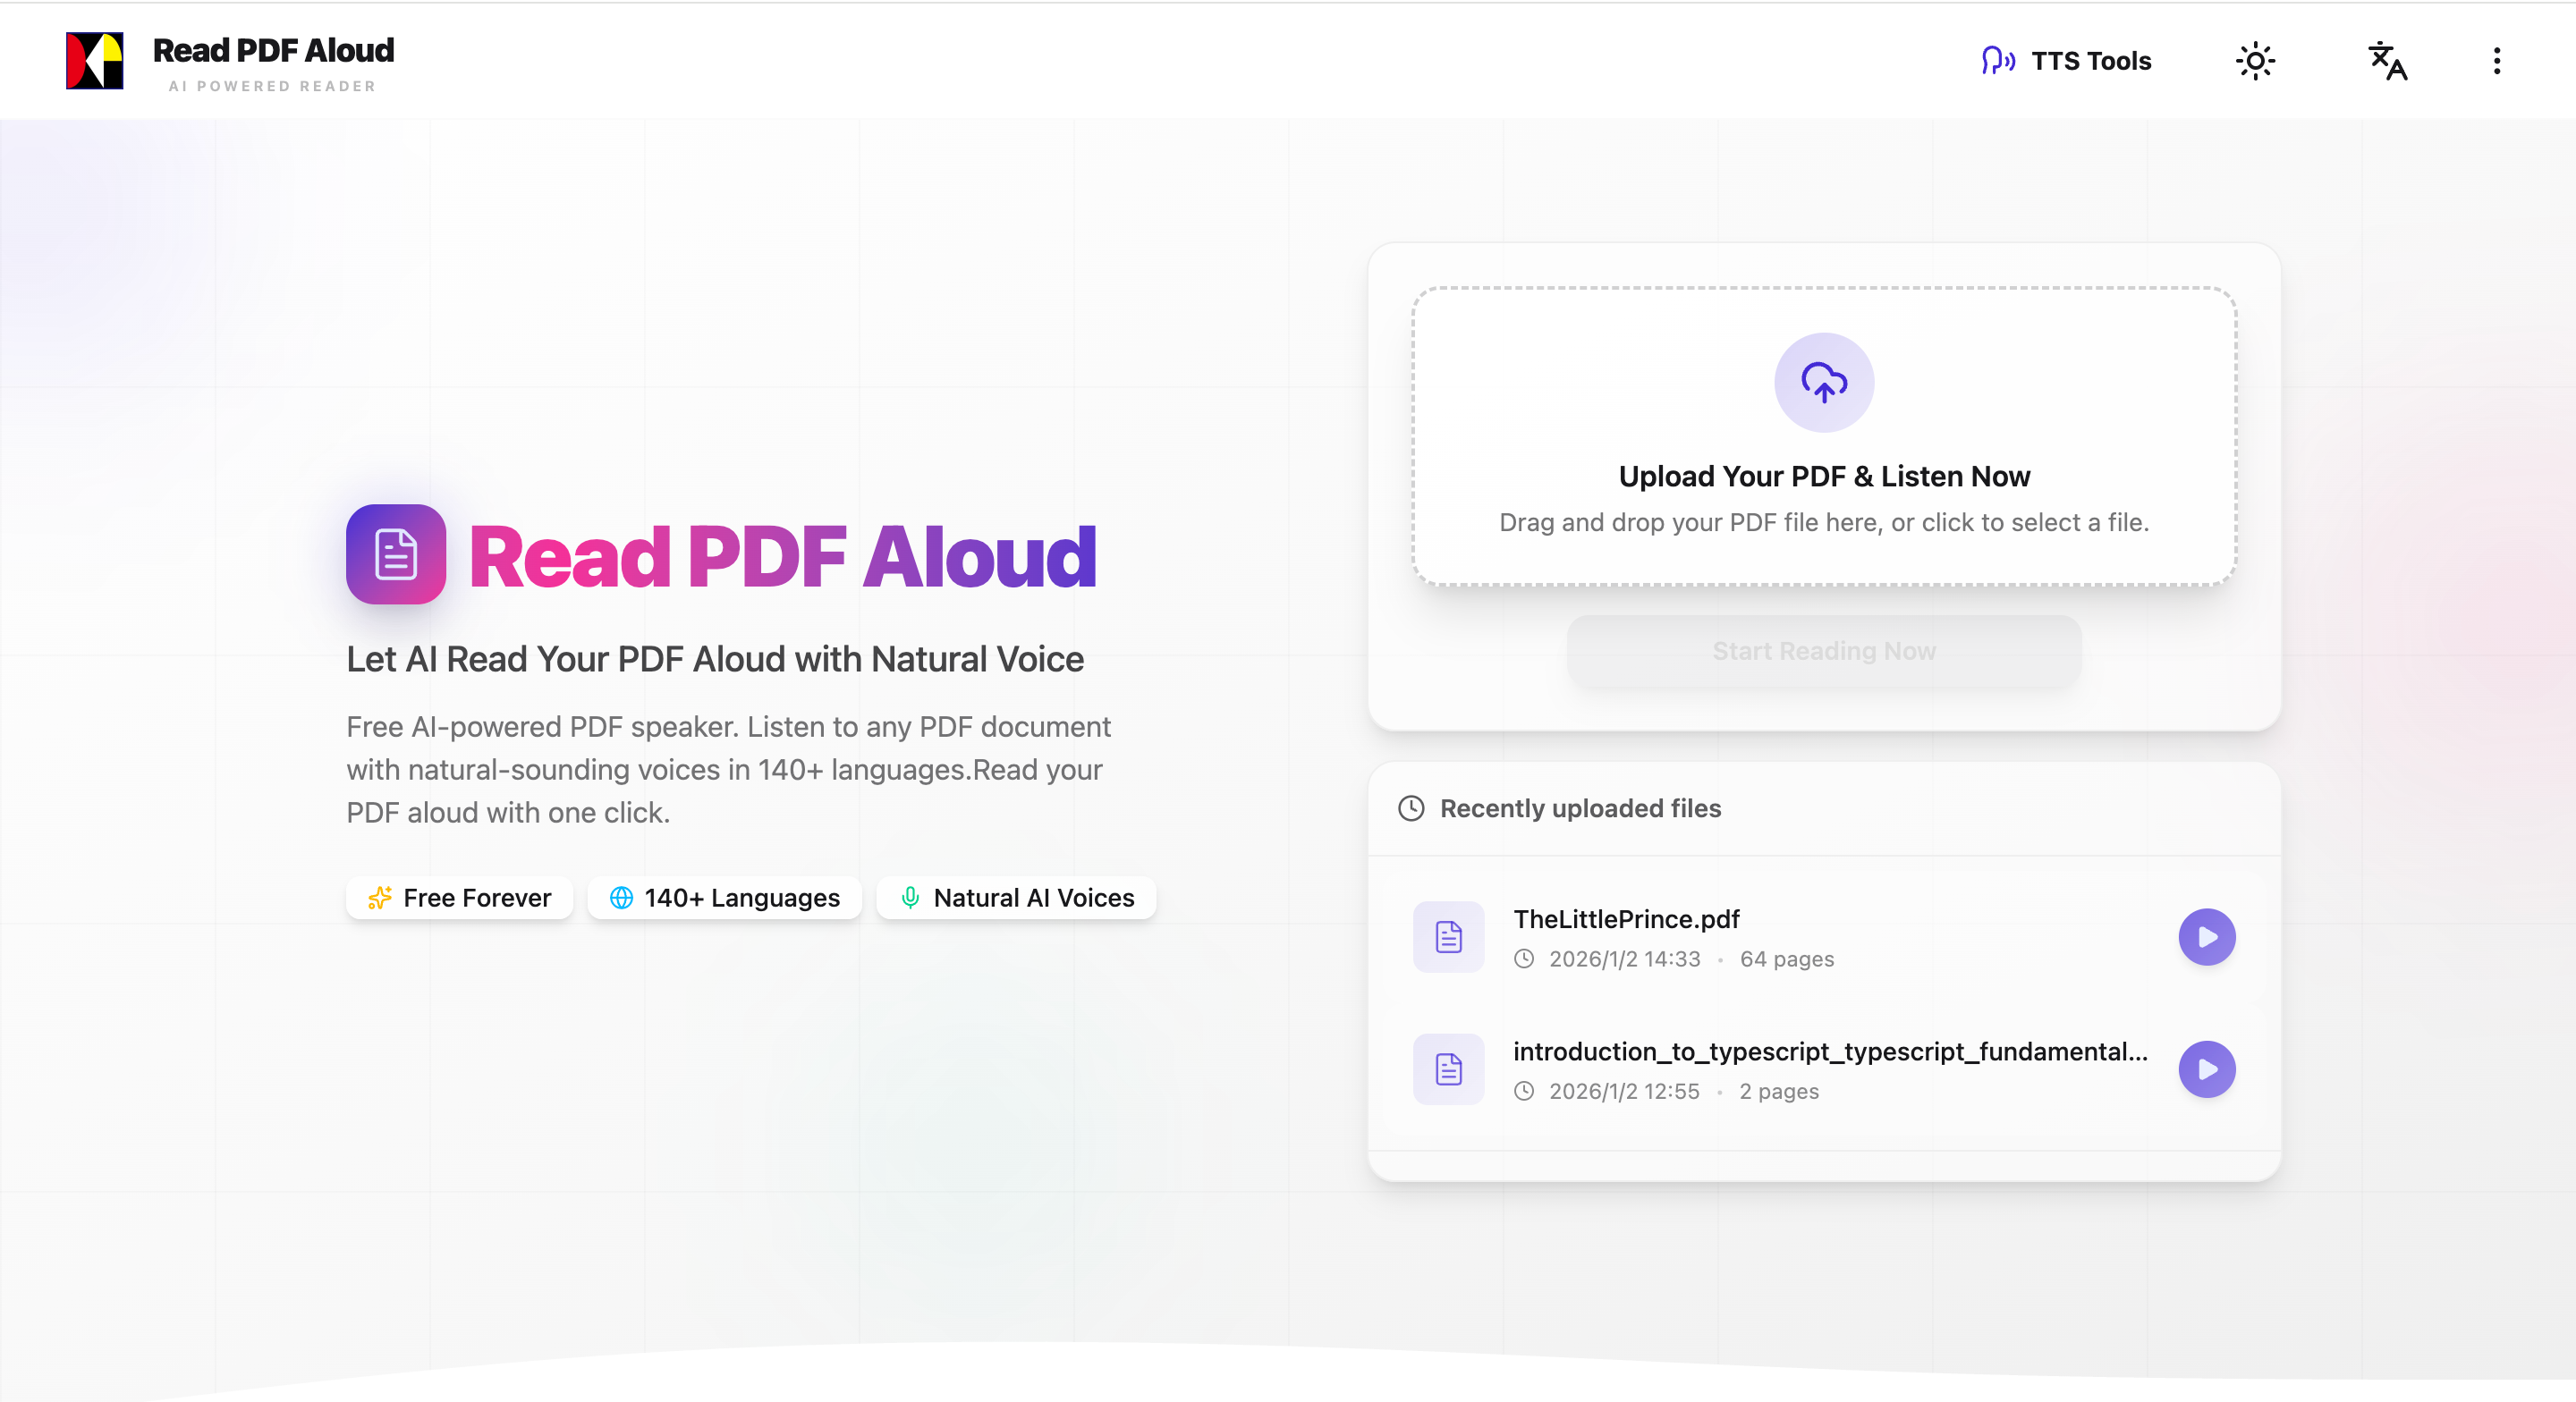
12 月 14 日开工,1 月 1 日凌晨上线第一版,到今天把已知的 bug 和不完善的地方全部修改完,一共花了大半个月的时间,是我工期最长的一个站。
Read PDF Aloud 核心的功能和交互相比之前的网站都要复杂,所以踩了不少坑,都是经验不足导致的。
程序设计上,这次核心的交互逻辑是用面向对象的方式完成。
svelte 的状态管理方式天然适配面向对象范式,官网文档上也专门就 runes 在 class 内的使用做了介绍。这次真正使用面向对象,我也感受到了面向对象的优势,心智负担低,越写越顺手。
但这一切建立在对象设计合理的基础上。如果一开始规划有问题,后面少不了返工。我这次就经历了推到重来的过程。
第二个坑是 CloudFlare Workers。这次的涉及到 PDF 的文字提取和 TTS Api 的调用,所以需要一些简单的后端功能。我最初为 PDF 解析和 TTS Api 调用编写了相应的后端接口,都非常简单。
但是,在我第一次部署到 Worker 后,我就遇到了后端报错。一开始我还以为是我部署方式不对,后来我又怀疑是不是我用的库不适配 Worker 环境。
看完 Worker 的后台日志以后,我才发现,错误原因是 Error 1102: Worker exceeded resource limits。
简单来说,就是 Worker 对单次请求消耗的 cpu 时间有限制。免费版是 10ms,付费版是 30s。一些计算量比较大的任务,难免会占用更多 cpu 时间。当时我心都凉了,一度考虑要不要租个服务器。我还上网查了一下,发现踩到这个坑的,不止我一个。
后来理智说服了我,在没有赚钱的情况下,不能乱花钱。那就只能让用户体谅一下我的难处了,把 PDF 解析放在了用户的浏览器里。
剩下的坑就是一些交互设计上的问题了。
我一直觉得写 ui 最浪费时间,因为很容易陷入细节调试的地狱,我就看这个设计不顺眼,但是又不知道怎么改好,想太久,时间就白白浪费了。
之前做的网站交互都比较简单,这个问题不明显。这次的交互方式更复杂,尤其是阅读器的界面,我边想边写边改,来来回回拉扯了两天。昨天上线,发现交互有问题,又改了一天。现在这版算是没有大毛病了。
编程好难啊。
更新于:2026 年 5 月 30 日
保存到飞书是一款 Chrome 浏览器插件,可以将当前网页内容一键保存到飞书云文档中,完全免费开源,你可以在 GitHub 上找到它的源码。
它可以:
它不能:
如果你想使用这款插件,可以点击下面的链接,前往 Chrome 插件商店下载:
如果你觉得好用,请 👇 🥹 👇


https://ai.feishu.cn/,或者 https://xxxxxx.feishu.cn/。你可以直接把飞书文档首页的链接复制过来,保存的时候插件会自动删除多余的部分。


Q: 插件是否会保存用户数据?
A:不会。插件所有的操作都是在用户本地浏览器中完成的,你的数据只会保存在浏览器里,卸载掉插件就会全部清空。插件不会将任何用户数据上传到第三方服务器,因为我没钱租服务器。
Q:为什么要手动填写这么多凭证信息,还要手动开通权限?
A:飞书有自动获取凭证和授权的方式,但是根据我对飞书开发文档相关章节段落的理解,我可能需要租一台服务器,再买个域名。我不想花钱,所以只能让用户手动填写这些信息。如果你有更好的做法,可以给我发邮件。
Q:个人版飞书可以使用吗?
A:可以。
Q:为什么我保存的内容中没有图片?
A:前面说了,部分网站的图片无法保存到飞书文档中。我不清楚是什么原因,但我猜应该是网站本身的限制。如果你有办法解决这个问题,可以给我发邮件。
Q: 有这么多已知缺陷为什么不改?
A:我不知道怎么改。你会你就教教我 🙇
Q:插件是否支持其他浏览器?
A:目前只支持 Chrome 浏览器 (以及所有基于 Chromium 的浏览器)。暂时没有计划支持其他浏览器。
Q:未来的更新计划?
A: who knows? 🤷
“保存到飞书”(以下简称“本扩展”)是一款旨在帮助用户将网页内容保存到飞书(Lark)文档或表格的浏览器扩展程序。我们非常重视您的隐私,并致力于保护您的个人数据。本隐私政策旨在说明我们收集哪些信息、如何使用这些信息以及如何保护这些信息。
"Save to Feishu" (hereinafter referred to as "the Extension") is a browser extension developed to help users save web content to Feishu (Lark) documents or tables. We value your privacy and are committed to protecting your personal data. This Privacy Policy explains what information we collect, how we use it, and how we protect it.
网页内容 / Web Page Content
我们收集什么: 当您点击扩展图标或触发保存操作时,本扩展会访问当前活动标签页的标题、URL、HTML 内容以及元数据(如作者、发布时间)。
我们如何使用: 这些信息仅在您的浏览器本地进行处理,用于提取文章正文,随后直接发送至飞书(Lark)API,以便保存到您指定的文档或表格中。
存储: 我们不会在我们的服务器上存储您的浏览记录或网页内容。数据仅经过短暂处理后即发送至飞书。
What we collect: When you click the extension icon or trigger a save action, the Extension accesses the title, URL, HTML content, and metadata (such as author, publish date) of the currently active tab.
How we use it: This information is processed locally in your browser to extract the main article content and is then sent directly to the Feishu (Lark) API to be saved into the document or table you specified.
Storage: We do not store your browsing history or web content on our servers. The data is transiently processed and sent to Feishu.
认证信息 / Authentication Information
我们收集什么: 为了与飞书进行交互,您需要提供飞书应用的 App ID 和 App Secret。
我们如何使用: 这些凭证仅用于从飞书认证服务器获取访问令牌(Access Token),从而允许本扩展向您的飞书账号写入数据。
存储: 这些凭证和生成的访问令牌均使用 chrome.storage.local 存储在您的浏览器本地。除飞书官方 API 接口外,它们绝不会被发送至任何第三方服务器。
What we collect: To interact with Feishu, you are required to provide Feishu App ID and App Secret.
How we use it: These credentials are used solely to obtain access tokens from Feishu's authentication servers, allowing the Extension to write data to your Feishu account.
Storage: These credentials and the generated access tokens are stored locally in your browser using chrome.storage.local. They are never sent to any third-party servers other than Feishu's official API endpoints.
用户配置 / User Configurations
我们收集什么: 我们会存储您的偏好设置,例如您创建的“保存目标”(飞书文档或多维表格配置)列表。
存储: 这些数据均存储在您的浏览器本地。
What we collect: We store your preferences, such as the list of "Save Targets" (Feishu Docs or Bitables configurations) you created.
Storage: This data is stored locally in your browser.
本扩展直接与 飞书(Lark)开放平台 进行交互。使用本扩展即表示您同意飞书关于其平台数据存储的隐私政策。我们不会将您的数据发送给任何其他第三方分析或追踪服务。
The Extension interacts directly with Feishu (Lark) Open Platform. By using this Extension, you are also subject to Feishu's Privacy Policy regarding the data stored on their platform. We do not send your data to any other third-party analytics or tracking services.
所有敏感数据(如令牌和凭证)均存储在您的本地设备上。与飞书 API 的通信全程采用 HTTPS 加密传输。
All sensitive data (such as tokens and credentials) is stored locally on your device. Communication with Feishu API is encrypted via HTTPS.
我们可能会不时更新本隐私政策。任何更改都将在此页面上发布。
We may update this Privacy Policy from time to time. Any changes will be posted on this page.
如果您对本隐私政策有任何疑问,请通过电子邮件 dkphhh@foxmail.com 联系开发者。
If you have any questions about this Privacy Policy, please contact the developer via the email dkphhh@foxmail.com.
第二个工具站Glitch Text Generator。
这次算是做了一个有用的东西,能帮你把文字变成特殊的风格样式,比如说:
Glitch Text,可以变成:
₲łıꮏȼħ Ꮏєӿꮏ
ǤɫɨŁčꚕ ₸€ҳŁ
Ԍłıŧϲħ Ŧєӿŧ
𝓖𝓵𝓲𝓽𝓬𝓱 𝓣𝓮𝔁𝓽
还可以变成:
G̸̨̨̣̪͈͎̩͔̟̦͇̞̹͉̦̣͓͟͡l̞̰̭̘̯i̶̵̢̠͉̹͙̠͚̲̟̯̯͡͝t̷̛̛̜̲̫̝̱͚̳͇̠̮̬͖͎̭͙̤̯̝̠͍̘͖̤͎̘́̀̍͑͝҉̸̧̛͕̤͚͍͍̗̪̺̜̹̞̮̜͎ͦͨ͜͡͡ͅ͏̵̷̡̛̠̝̫̜̞̞͙̩̖̫̮̗͉̖͕̼̲̖̗̞̻̯͕̺̥̇̕͢c̵̢̡̦͚͈̻͕͕̭̭̤̘̣̙̺͙̬̟̖̭̥̻͗ͯͧͣ̀͢͝h̷̡̛̫̮͈̪̫̗̣̞̱̬̰͔̩͉̯͍̦̥̣̲̮̰̪͖̝̿̈́͊̀̀ͦ͘͟͜͜͞ ̡͇̫̳̞̳҉̨̹͉̟̳̹҉̨T̶̶̢̛͖̱͍̳̩̪̪̗̯͉͉̗̬̖͎̻͈̝͈̥̖̯̯̬̠̩͚̩͇͉͚͔͖̼̣̙̥̳̥̜̹̜̲̼̜̱͚̩͙̈͌͊͗̐̕͟͟͟͢͟͢͝͠͠͡ͅȩ̵͜͡͝x̮̻̱͎͕͜҉̶̷̷̷̷̶̢̢̧̯̘̣̣̝̙͓̬͈̰͙̜̤͎̮̜̪͇̼͇͙͈̖̻̠̟̝̥̘̫̥̟̮̠̮͉̝̪͖̬̬̺̤̙̞̯̤̯͍̪̟́̑ͣ͂̃̅͘͟͢ͅͅͅͅt̳̹̝͈͚҉̵̷̢̧̢̡̛̲̫͕̮̫̱͉͓̲̼̪̟̱̟̝͔̙̺̰̳̬͓̟̘͚̺͙͙̯͎̪̜̫̺̘̰͔̜̼͎̞̺͇̦͎͍̟̯̌ͫ̐ͯ̕͟͟͞͠ͅͅ҉̶̢̫̮͕͈̞̉̕͢͟͢
其原理是 Unicode 字符变体。
Unicode 字符集中有很多不同的字符,这些字符看起来很像,但实际上是不同的编码。
例如,字母 "A" 有多种变体,如 "𝐀"(粗体 A)、"𝔄"(哥特体 A),还有"₳"(阿根廷比索符号)。
Unicode 字符集里有很多奇奇怪怪的字符,甚至还有古埃及象形文字 AKA 圣书体:
𓂀 𓆐 𓆡 𓆦
开发网站,在 cloudflare 买域名,用 Vercel 部署上线,添加 Google Analytics 和 Microsoft Clarity 的流量分析工具,最后集成 Google Adsense 代码。
满打满算用了两天时间 -> 2025-11-07_01-27-01。
现在有一种追完了电视剧的无力感。
我能做的都做了,好像也没有那么复杂。除了开发网站,剩下的事情点点鼠标就能干。
我似乎有些迟钝。我才意识到做个人站长是一个什么样的行当。
怎么形容呢?这一行拼的其实是捕捉新需求的能力。
同行都是用赛博化身活跃在网络丛林里的赏金猎人。新鲜的需求就是猎物,在绝大多数时候是先到先得。或者花更多的时间和成本,兴许也能把老站压下去。
我现在就是一个刚刚在猎人公会注册成功的新猎人。手里的武器没有那么顺手,也不知道猎物在哪儿。
我现在自由了,可以用尽我所有的手段和方法。但是我也迷茫了,因为我还不知道有什么手段和方法可以利用。
这是真正的丛林世界,没有人会手把手教你怎么做。
毕竟每一个需求都是货真价实的流量和金钱。
谁会把这些拱手让人呢?
本人第一个出海工具站上线了。Elf name Generator 试水性质。明天把谷歌收录和必应收录的代码加上去,再加上一点数据监控的东西,看看有没有流量进来吧。